
arXiv: چارچوب SRHarness؛ توانمندسازی عاملهای هوشمند علمی برای کشف فرمولها و تحلیل سازوکارها
 مقدمه
آیا دستیابی هوش مصنوعی به یک فرمول ریاضی، بهمعنای درک علمی آن پدیده است؟ Data Science and Intelligence Laboratory در Tsinghua University چارچوبی به نام SRHarness ارائه کرده است که به عاملهای هوشمند امکان میدهد فرمولهای ریاضی را با اتکای بیشتری از دادههای تجربی استخراج کنند. همزمان، این تیم معیاری تحت عنوان MechBench طراحی کرده است تا توانایی هوش مصنوعی را در پردهبرداری از سازوکارهای بنیادین پشت این فرمولها بسنجد. این دو پژوهش در کنار هم، مرحله بعدی کشف علمی توسط هوش مصنوعی را هدف قرار دادهاند: عبور از توصیف «چیستی» و رسیدن به تبیین «چرایی».
حوزههای پژوهش: SRHarness، MechBench، رگرسیون نمادین (Symbolic Regression)، عاملهای علمی، کشف سازوکار، استنتاج بهترین تبیین (Abductive Reasoning)
منبع: Data Science and Intelligence Laboratory در دپارتمان مهندسی الکترونیک Tsinghua University
به تازگی Data Science and Intelligence Laboratory در دپارتمان مهندسی الکترونیک Tsinghua University در حوزه AI for Science، چارچوب اجرایی SRHarness [1] را برای رگرسیون نمادین مبتنی بر عاملهای هوشمند (agentic symbolic regression) معرفی کرده است تا هوش مصنوعی بتواند فرمولها را با اطمینان بالاتری از دادههای مشاهداتی کشف کند. این تیم همزمان بنچمارک ارزیابی سازوکار MechBench [2] را توسعه داده است تا بررسی کند که آیا هوش مصنوعی قادر است پرده از سازوکار نهفته در پس فرمولها بردارد یا خیر.
این دستاورد، ادامه پژوهشهای پیشین این تیم است که پیشتر چارچوب استنتاج بهترین تبیین در هوش مصنوعی (Abductive AI) را در نشریه Nature Reviews Physics [3] و روش رگرسیون نمادین عصبی ND² را در نشریه Nature Computational Science [4] منتشر کرده بودند.
این دو دستاورد مکمل یکدیگرند و به دو پرسش کلیدی در کشف علمی مبتنی بر هوش مصنوعی پاسخ میدهند: «فرمولهای ریاضی چگونه کشف میشوند؟» و «آیا هوش مصنوعی واقعاً سازوکار فیزیکی پشت این فرمولها را میفهمد؟». این رویکرد به پیشرفت کشف علمی توسط هوش مصنوعی از «انطباق با مشاهدات» به سمت «درک سازوکار» کمک میکند.
نتایج آزمایشها نشان میدهد که با استفاده از مدل پایه DeepSeek-v4-flash-0731، نرخ بازیابی نمادین SRHarness در آزمونهای ناشناسسازیشده به ۷۲٫۹۷ درصد میرسد که بسیار بالاتر از نرخ ۲۰٫۷۲ درصدی Codex بوده و با عملکرد Codex مجهز به GPT-5.5 و GPT-6-Astra برابری میکند. از سوی دیگر، نتایج MechBench حاکی از آن است که حتی Codex مجهز به GPT-5.6-sol در مجموعه هسته، تنها به نرخ بازیابی سازوکار ۱۳٫۷۵ درصدی دست یافته که بسیار پایینتر از نرخ بازیابی الگوی ۳۵٫۰۰ درصدی آن است. این شکاف نشان میدهد که میان پیشرفتهترین عاملهای هوشمند علمی کنونی در «کشف الگوها» و «درک سازوکارها» همچنان فاصلهای عمیق وجود دارد.
 دو مقاله مرتبط با این پژوهش: SRHarness (بالا) و MechBench (پایین)
۱. دو گام بنیادین در کشف علمی: از کپلر تا نیوتن
استخراج الگوهای ریاضیِ توصیفکننده پدیدهها از دادههای تجربی و سپس واکاوی سازوکارهای فیزیکی پشت آنها، مسیری کلاسیک در تاریخ علم است. بیش از چهارصد سال پیش، یوهانس کپلر با اتکا به دادههای رصدی، قوانین حرکت سیارات را فرمولبندی کرد و با دقت نشان داد سیارات «چگونه حرکت میکنند». در ادامه، مکانیک نیوتنی گامی فراتر نهاد و بر پایه گرانش عمومی، از نظر فیزیکی تبیین کرد که سیارات «چرا اینگونه حرکت میکنند». گذار از کپلر به نیوتن، نماد گذار تاریخ علم از «کشف فرمول ریاضی» به «کشف سازوکار فیزیکی» است. امروزه مدلهای زبانی بزرگ (LLM) و عاملهای علمی هوشمند (Scientific Agent) میتوانند دادهها را تحلیل کنند، ابزارها را به کار بگیرند، فرضیهها را بازبینی نمایند و نقشی کلیدی در اکتشافات علمی ایفا کنند. در این میان پرسشی بنیادین پدید میآید: آیا هوش مصنوعی در ابتدا میتواند الگوهای پایدار نهفته در دادهها را بهدرستی کشف کند؟ و پس از آن، آیا قادر است سازوکار زیربنایی این الگوها را دریابد؟ پژوهشگران برای پاسخ به این دو مسئله، دو نوآوری ارائه کردهاند: نخست، معرفی SRHarness به عنوان زیرساختی با قابلیت استفاده مجدد، ذخیرهسازی دادهها و رهگیری فرآیندها در رگرسیون نمادین، که به عاملهای هوشمند اجازه میدهد فرمولهای ریاضی را با قابلیت اتکای بالاتری بیابند؛ نرخ بازیابی نمادین این سامانه در ارزیابیهای استاندارد به ۹۳٫۶۹ درصد رسیده که نسبت به بهترین روشهای پیشین بیش از ۳۰ واحد درصد بهبود یافته است. دوم، ایجاد بنچمارک MechBench برای سنجش نظاممند توانایی هوش مصنوعی در استنتاج سازوکارهای پنهانی که مستقیماً قابل مشاهده نیستند، اما پدیدهها را تبیین میکنند. این بنچمارک برای نخستین بار تمایزی آشکار میان «بازیابی الگوهای تجربی» و «بازیابی سازوکارهای زیربنایی» قائل شده و معیاری عینی برای سنجش «درک واقعی» هوش مصنوعی از علم به شمار میرود.
۲. استخراج مطمئن فرمولها توسط هوش مصنوعی: چارچوب SRHarness
با گذار رگرسیون نمادین از حالت «تولید صرف فرمول توسط مدلهای زبانی» به سامانههای مبتنی بر عامل که میتوانند دادهها را ارزیابی کنند، ابزارها را فرابخوانند و فرضیهها را بازبینی نمایند، زیرساخت محاسباتی این تعاملات پیچیده اهمیت ویژهای یافته است. اگرچه پروژههای پیشین بخشهایی از این سازوکارها را پیاده کرده بودند، اما آنها صرفاً در چارچوب سامانههای اختصاصی طراحی شده بودند و محیط زیرساختی Harness به شکل بستری مستقل و بازکاربردپذیر مد نظر قرار نگرفته بود. سامانه SRHarness این لایه زیرساختی را به شکلی نظاممند تعریف کرده است. این سامانه استراتژی جستجوی خاصی را تحمیل نمیکند، بلکه بستری فراهم میسازد که مدلها و روشهای گوناگون جستجو بتوانند روی آن اجرا شوند. این چارچوب سه بخش محوری دارد (تصویر ۱):
- کنشهای علمی چندبارمصرف (Reusable Scientific Actions): کپسولهسازی ابزارهای تحلیل، برازش، جستجو و ارزیابی به صورتی یکپارچه که عملیات تحلیل داده، بهینهسازی عددی، موتورهای نمادین و بررسی گزینهها را استاندارد میکند. این قابلیت به عملیات ناهمگن امکان میدهد از طریق یک رابط واحد اجرا شوند و عامل هوشمند بدون درگیر شدن با جزئیات سطح پایین، بر «نوع اقدام» تمرکز کند.
- وضعیت علمی پایدار (Persistent Scientific State): بهروزرسانی و ثبت مداوم فرمولهای پیشنهادی به همراه شواهد علمی آنها، بهگونهای که فرضیهها، نتایج ارزیابی، سطح پیچیدگی و پیشینه تصمیمگیریها مستقل از حافظه کوتاهمدت پنجره گفتگو نگهداری شده و امکان مقایسه، رتبهبندی و استفاده مجدد در مراحل بعدی فراهم شود.
- مدیریت چرخه عمر مسیر جستجو (Trajectory Lifecycle Management): کنترل ادامه، شاخهبندی، شروع مجدد و خاتمه فرایند جستجو در مراحل طولانی، با قابلیت پایش مراحل، بازیابی پس از خطا و حفظ بهترین نتایج بهدستآمده، تا جستجوهای طولانیمدت علمی شفاف، قابل ارزیابی و قابل بازگشت باشند.
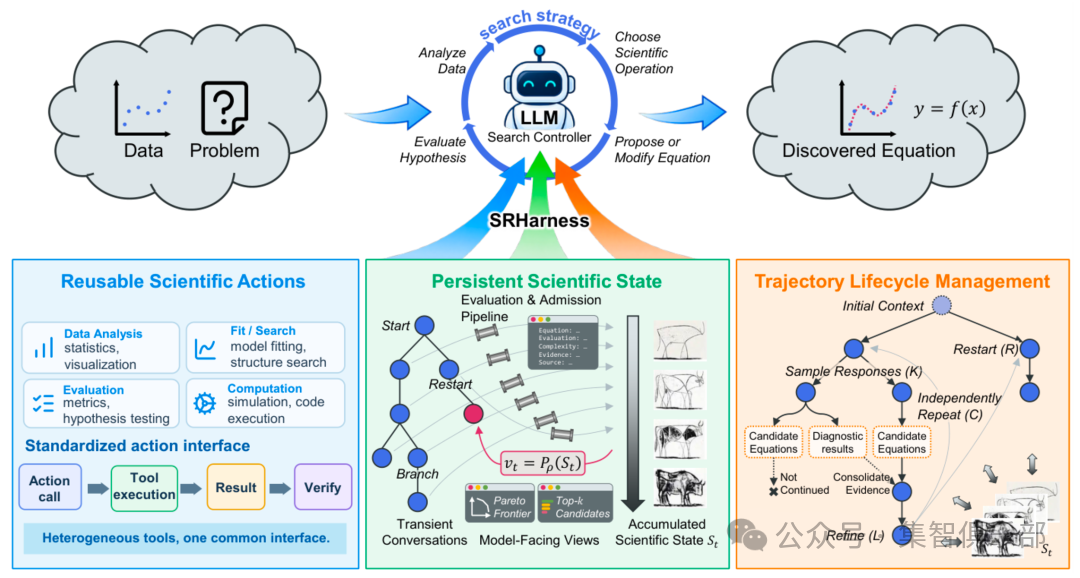 تصویر ۱: ساختار کلی سامانه SRHarness. لایه فوقانی کنترلکننده جستجوی مبتنی بر مدل زبانی بزرگ است که از طریق چرخه بسته «تحلیل داده — ارزیابی فرضیه — انتخاب اقدام علمی — پیشنهاد یا اصلاح معادله»، جستجوی نمادین را هدایت میکند. لایه زیرین شامل سه بخش است: کنشهای علمی چندبارمصرف (رابط ابزارها)، وضعیت علمی پایدار (انباشت فرمولها و مدیریت جبهه پارتو) و مدیریت چرخه عمر مسیر جستجو (هماهنگی ادامه، شاخهبندی، راهاندازی مجدد و توقف).
بر این اساس، SRHarness به سامانهای کامل تبدیل شده که مستقیماً در پروژههای رگرسیون نمادین و کشف فرمولهای علمی به کار میرود و بخشهای تحلیل داده، برازش عددی، جستجوی نمادین، مدیریت گزینهها، ارزیابی، پایداری وضعیت و بازیابی خطا را پوشش میدهد. پژوهشگران همچنین میتوانند ابزارهای علمی و روشهای جستجوی تخصصی خود را به آن افزوده و عاملهای اختصاصی بسازند.
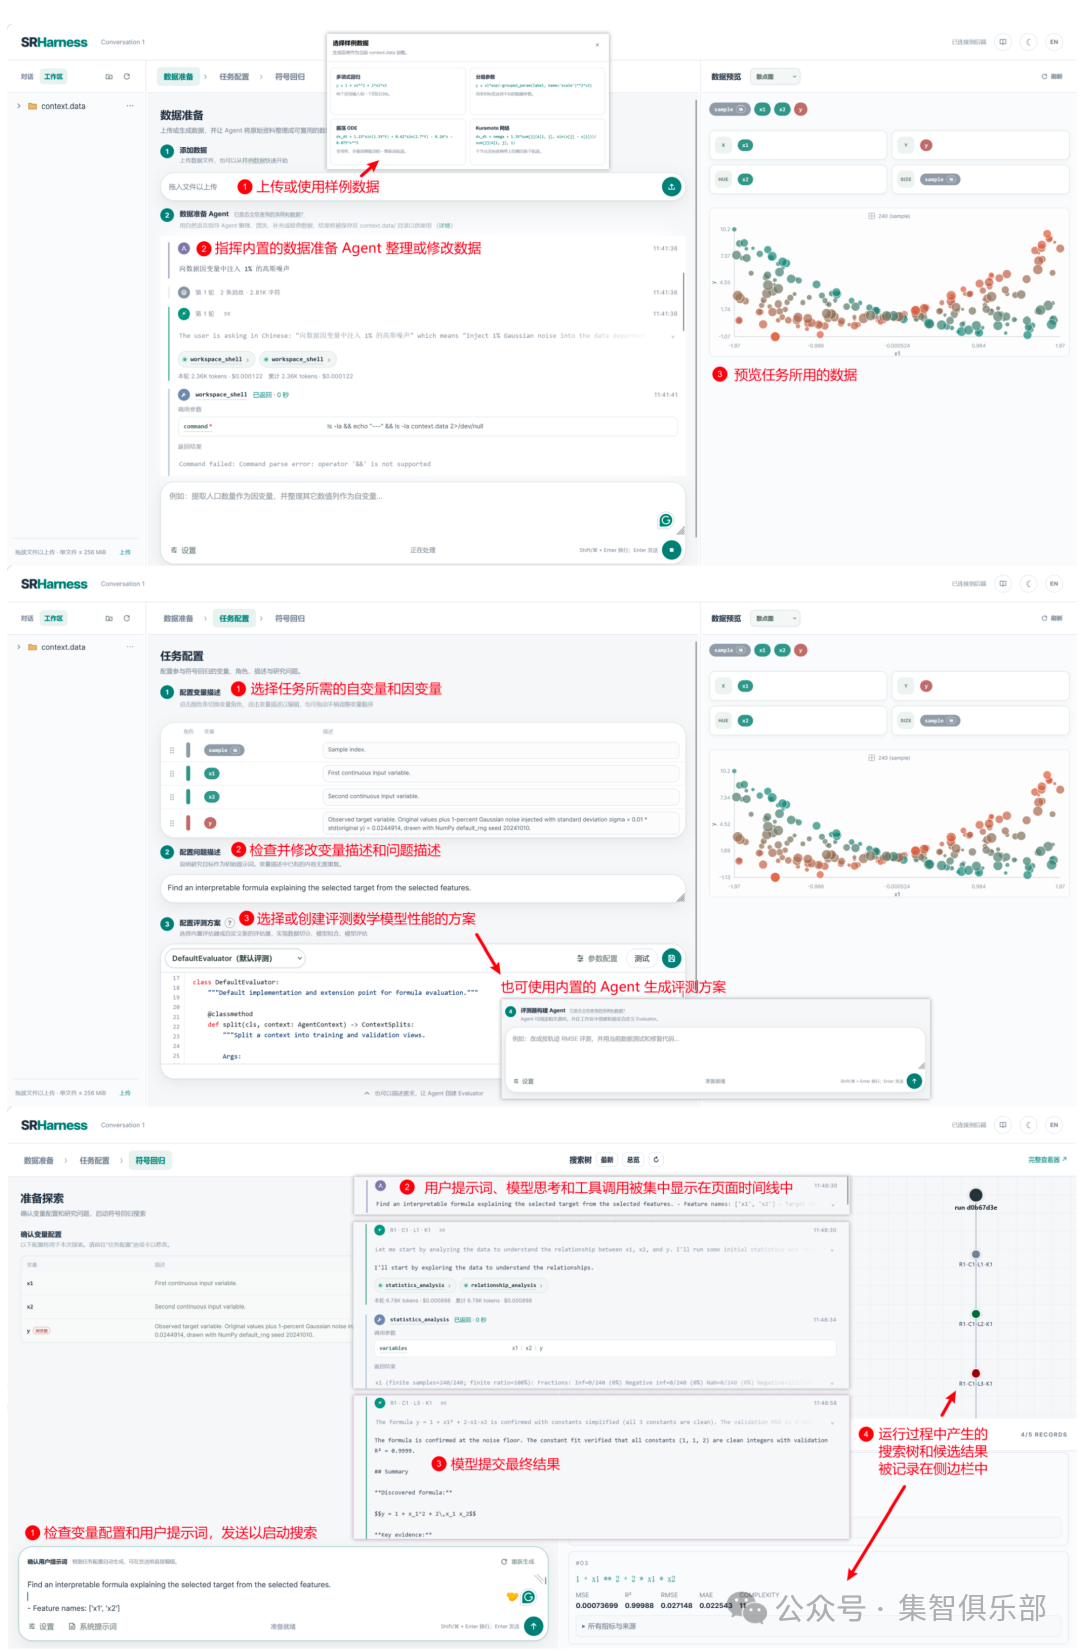
این بستر به صورت منبعباز منتشر شده و کدها، مستندات و پیشنمایش آنلاین آن در دسترس است. کدها در GitHub میزبانی میشوند و از طریق PyPI قابل نصب هستند؛ علاوه بر این، یک نسخه نمایشی آنلاین طراحی شده تا کاربران بتوانند فرایند کامل تحلیل داده تا کشف فرمول را به صورت مستقیم در مرورگر بررسی کنند.
نشانی GitHub: https://github.com/tsinghua-fib-lab/SRHarness
مستندات راهنما: https://yuzhthu.github.io/SRHarness/
نسخه آنلاین: http://sim1.fiblab.tech:30000/
 آزمایشها نشان میدهد که با استفاده از مدل DeepSeek-v4-flash، نرخ بازیابی نمادین SRHarness در معیار ارزیابی LSR-Transform به ۹۳٫۶۹ درصد میرسد که نسبت به روش SR-Scientist (ICLR 2026) با رکورد ۶۲٫۱۶ درصد، رشدی بیش از ۳۰ واحد درصد (حدود ۵۰ درصد بهبود نسبی) داشته و رکورد تازهای در این معیار ثبت کرده است. افزون بر این، در بنچمارک LSR-Synth در چهار حوزه فیزیک، شیمی، زیستشناسی و علم مواد، دقت پیشبینی دادههای خارج از توزیع به ترتیب به ۷۸٫۰۰٪، ۷۸٫۸۷٪، ۸۷٫۰۹٪ و ۹۶٫۰۰٪ رسیده است.
نکته حائز اهمیت این است که حتی پس از حذف مفاهیم علمی و معنای متغیرها از صورت مسئله (در آزمون LSR-Transform-Anon)، سامانه SRHarness با نرخ بازیابی ۷۲٫۹۷ درصدی به معادلات هدف دست یافته است؛ در حالی که این رقم برای SR-Scientist برابر ۳۹٫۶۴ درصد و برای Codex با مدل مشابه، ۲۰٫۷۲ درصد بوده است. این نتیجه حتی از عملکرد Codex هنگام استفاده از مدل قدرتمندتر GPT-5.5 (که ۶۸٫۴۷ درصد ثبت کرده) بالاتر است. همچنین در مقایسه با GPT-6-Astra، چارچوب SRHarness توانسته است با مدلی سبکتر به کارایی مشابهی دست یابد. این یافتهها گویای آن است که SRHarness نه تنها از دانش پیشین نهفته در مدلهای زبانی بهره میگیرد، بلکه با برقراری تعامل فعال با دادهها، تحلیل ساختاری، بررسی فرضیهها و جستجوی مرحلهبهمرحله را پیش میبرد تا ساختارهای ریاضی را صرفاً از روی دادههای عددی استخراج کند.
با توجه به توانایی بالای مدل GPT-6-Astra در استدلالهای ریاضی، ارزیابیهای تکمیلی نیز برای مقایسه با آن صورت گرفت. بر اساس نتایج، SRHarness تنها با بهرهگیری از مدل بهینهتر DeepSeek-v4.1-flash در بنچمارک LSR-Synth عملکردی نزدیک به ترکیب Codex با GPT-6-Astra ارائه داده است؛ به طوری که به دقت کلی ۹۵٫۵۲ درصد برای دادههای درون توزیع و ۹۲٫۴۱ درصد برای دادههای خارج از توزیع دست یافته است. در این میان، دقت دادههای خارج از توزیع در حوزه زیستشناسی به ۹۸٫۵۹ درصد و در علم مواد به ۱۰۰ درصد رسیده که عملکردی همتراز یا بسیار نزدیک به GPT-6-Astra به شمار میرود. این شواهد نشان میدهد که با اتکا به یک ساختار اجرایی هدفمند برای پژوهشهای علمی، مدلهای سبکتر نیز میتوانند به سطح پیشرفتهترین عاملهای هوشمند نزدیک شوند.
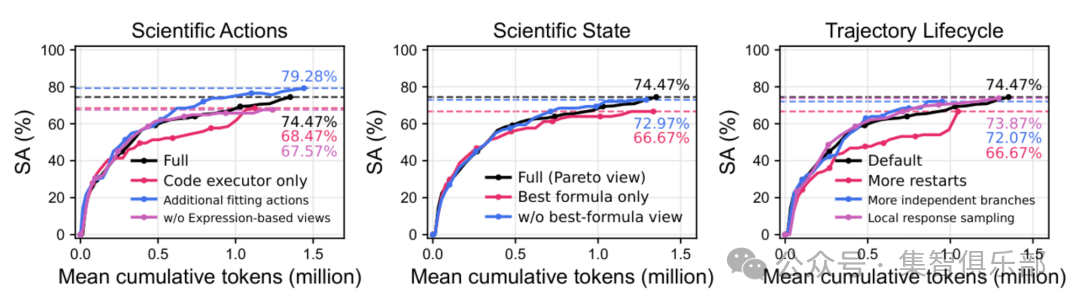 تصویر ۲: آزمایشهای حذف بخشها (Ablation) در بنچمارک LSR-Transform-Anon. با سادهسازی یا حذف اجزای کلیدی در بخشهای کنشهای علمی چندبارمصرف (چپ)، وضعیت علمی پایدار (وسط) یا مدیریت چرخه عمر مسیر (راست)، نرخ بازیابی نمادین (SA) افت محسوسی نشان میدهد. برای نمونه، حفظ صرف بخش اجرای کد نرخ بازیابی را از ۷۹٫۲۸٪ به ۶۷٫۵۷٪، حفظ صرف بهترین فرمول آن را از ۷۴٫۴۷٪ به ۶۶٫۶۷٪ و راهاندازیهای مجدد بیش از حد، بازدهی را از ۷۴٫۴۷٪ به ۶۶٫۶۷٪ کاهش داده است. این امر نشاندهنده لزوم همزمانی این سه سازوکار است.
۳. فراتر از استخراج فرمول:
آیا هوش مصنوعی سازوکارها را تبیین میکند؟
شناسایی فرمولها و روابط ریاضی لزوماً به معنای درک سازوکارهای فیزیکی نیست. روشها و معیارهای موجود در رگرسیون نمادین غالباً با هدف بازسازی مدلهای پدیدارشناختی (Phenomenological models) طراحی شدهاند که تنها رفتار مشاهداتی را بیان میکنند و برازش مطلوب دادهها را معیار موفقیت میدانند. با این حال، همانطور که قوانین کپلر دلیل حرکت سیارات را توضیح نمیدهند، رسیدن به یک معادله پدیدارشناختی صحیح نیز دلیلی بر شناخت سازوکار حاکم بر آن نیست.
برای حل این چالش، پژوهشگران بنچمارک MechBench را طراحی کردهاند که مرز میان «بازیابی الگوی تجربی» و «کشف سازوکار زیربنایی پدیدآورنده الگو» را مشخص میکند (تصویر ۳). مدلهای پدیدارشناختی رابطه میان متغیرهای ورودی، تنظیمکنندهها و خروجیهای مشاهدهپذیر را فرمولبندی میکنند، در حالی که مدلهای سازوکاری، اجزا، روابط و ساختار درونی تولیدکننده پدیدهها را تبیین کرده و متغیرهای علمی درونی را که از مدلهای پدیدارشناختی قابل استخراج نیستند، در بر میگیرند.
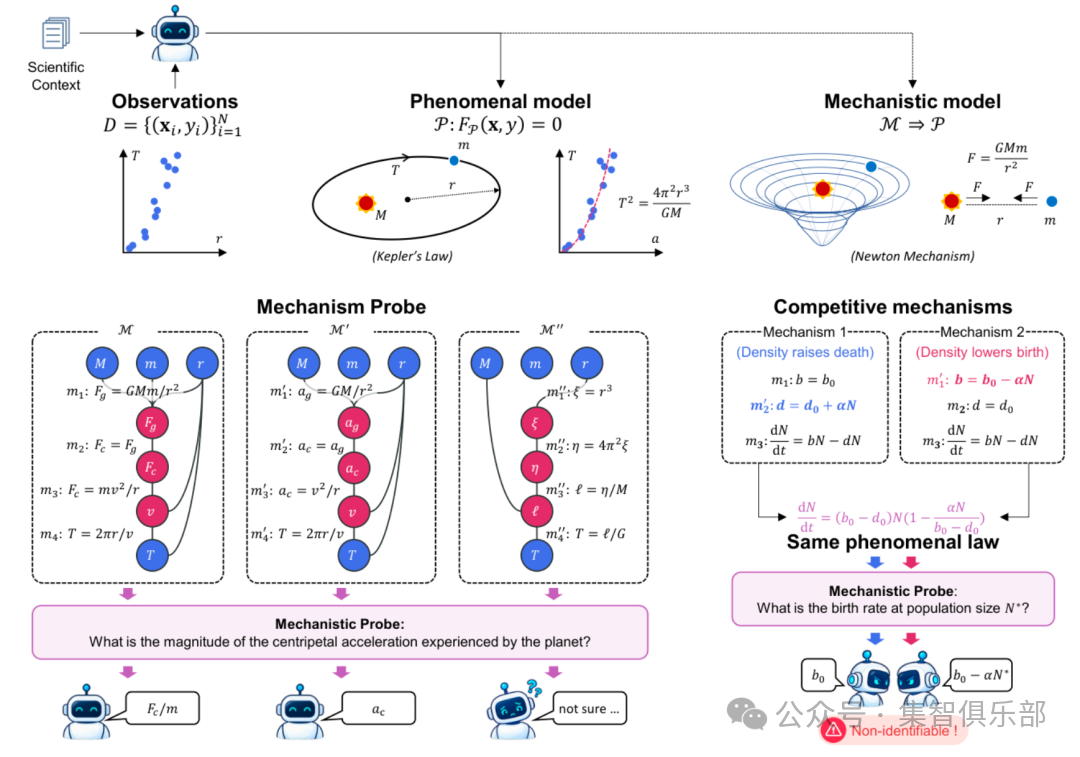 تصویر ۳: تمایز میان الگوهای پدیدارشناختی و کشف سازوکار. ردیف بالا با مثال حرکت سیارات: قوانین کپلر (مدل پدیدارشناختی) روابط میان متغیرهای رصدی را توصیف میکنند و مکانیک نیوتنی (مدل سازوکاری) منشأ این قوانین را شرح میدهد. ردیف پایین، سمت چپ: کاوشگر سازوکار (Mechanism Probe) برای ارزیابی اینکه آیا سازوکار پیشنهادی میتواند کمیتهای علمی درونیِ نامشخص در مدلهای تجربی (مانند شتاب جانب مرکز سیاره) را محاسبه کند یا خیر؛ سمت راست: غربالگری سازوکارهای رقیب (Competitive Mechanisms) به منظور برطرف کردن مسئله عدم تفکیکپذیری ناشی از پدید آمدن مشاهدات یکسان توسط چند سازوکار مختلف.
طراحی بنچمارک برای سنجش سازوکارها با چالشهایی همراه است: ساختار سازوکارها باید به صورت عینی قابل ارزیابی باشد؛ باید میان «بازسازی واقعی سازوکار» و «حفظ کردن پاسخهای کتابهای درسی» تفکیک قائل شد؛ و مسئله «عدم تفکیکپذیری سازوکاری» (Mechanistic indistinguishability) نیز باید مدیریت شود؛ چرا که چندین فرآیند علمی متمایز ممکن است رفتارهای ظاهری کاملاً مشابهی بروز دهند.
مراحل ساخت و ارزیابی MechBench در تصویر ۴ ارائه شده است. در این چارچوب، ۱۶ مجموعه مسئله علمی تجربی از علوم فیزیک، شیمی، زیستشناسی و علم مواد انتخاب شده و با اعمال تغییرات کنترلشده بر آنها، سامانههای سازوکاری ناشناختهای بازسازی شدهاند تا از بازگویی پاسخهای حفظشده توسط مدلها جلوگیری شود. بر این اساس، مجموعهای شامل ۵۱۲ مسئله طراحی شده و ۸۰ مسئله نیز به عنوان مجموعه هسته برای بررسیهای دقیقتر در نظر گرفته شده است. در هر مسئله، تنها دادههای رصدی و پیشینه علمی در اختیار عامل قرار میگیرد و از آن خواسته میشود الگوهای مشاهداتی و سازوکارهای بنیادین را همزمان بازسازی کند. برای بررسی دقیق سازگاری سازوکار کشفشده با مدل مرجع، کاوشگرهایی طراحی شدهاند که محاسبه کمیتهای درونی را میسنجند؛ همچنین با غربالگری سازوکارهای رقیب، موارد مبهم حذف میشوند.
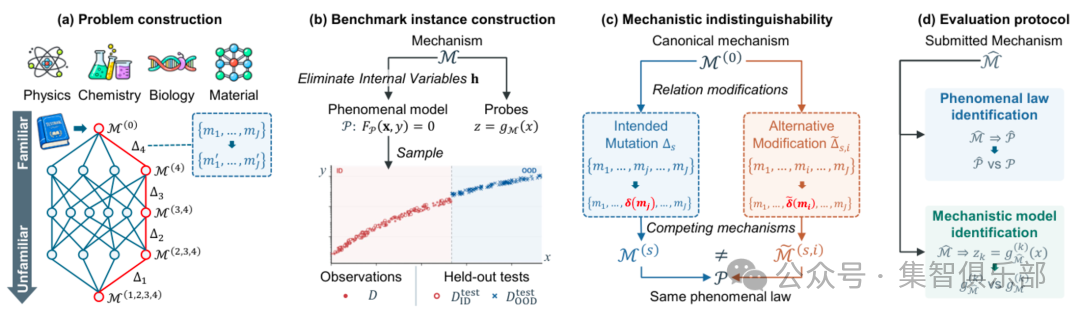 تصویر ۴: فرایند ایجاد و اعتبارسنجی در MechBench. الف) صورتبندی مسئله: ایجاد دگرگونی در سازوکارهای کلاسیک برای تولید ساختارهای نو؛ ب) تولید نمونههای آزمون: حذف متغیرهای درونی و ایجاد دادههای مشاهداتی همراه با دادههای ارزیابی خارج از توزیع؛ ج) بررسی تفکیکپذیری: یافتن سازوکارهای جایگزین و حذف ابهامات؛ د) فرایند سنجش: ارزیابی همزمان قواعد پدیدارشناختی و مدلهای سازوکاری که نیازمند پیشبینی مقادیر متغیرهای درونی است.
با استفاده از MechBench، پژوهشگران توانمندی مدلهای پیشرفته را در دو حوزه کشف الگو و کشف سازوکار مقایسه کردند که نشاندهنده تفاوت چشمگیر میان این دو حوزه است (تصویر ۵). برای نمونه، مدل Codex با GPT-5.6-sol در مجموعه هسته به نرخ بازیابی الگوی ۳۵٫۰۰ درصدی دست یافته، در حالی که نرخ بازیابی سازوکار آن تنها ۱۳٫۷۵ درصد بوده است. حتی در مواردی که الگوهای ظاهری به درستی شناسایی شدهاند، این سامانه در ۶۴٫۲۹ درصد مواقع در درک سازوکار ناموفق عمل کرده است. علاوه بر این، حتی اگر فرمول صحیح پدیدارشناختی مستقیماً در اختیار عامل قرار گیرد، نرخ بازیابی سازوکار آن همچنان کمتر از ۵۰ درصد باقی میماند (۴۵٫۰۰٪ در مجموعه هسته و ۴۹٫۰۲٪ در کل مسائل).
برای سنجش این رویکرد در جدیدترین مدلها، مدل GPT-6-Astra نیز مورد بررسی قرار گرفت. این مدل نرخ بازیابی الگوهای پدیدارشناختی را در مجموعه هسته به ۷۲٫۵۰ درصد رساند که نشاندهنده پیشرفت در شناسایی روابط ریاضی است، اما نرخ بازیابی سازوکار آن روی ۴۷٫۵۰ درصد متوقف شد؛ بدین معنا که در ۴۳٫۱۰ درصد از مواردی که فرمول درست استخراج شده، مدل از بازیابی کامل سازوکار بازمانده است. در مسائل پیچیدهتر با پنج مؤلفه متغیر، GPT-6 توانسته ۵۰٫۰۰ درصد فرمولها را استخراج کند، اما تنها ۱۲٫۵۰ درصد از سازوکارهای بنیادین را به درستی تشخیص داده است.
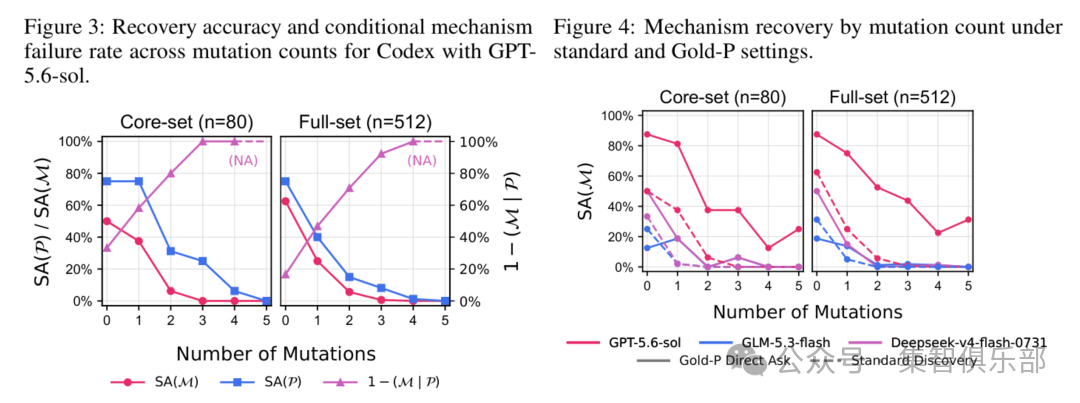 تصویر ۵: فاصله میان کشف الگو و کشف سازوکار. نمودار چپ (تصویر ۳ مقاله): با افزایش مؤلفههای ناشناخته، نرخ بازیابی الگو SA (P) و بازیابی سازوکار SA (M) کاهش مییابند، اما افت بازیابی سازوکار با شیب تندتری رخ میدهد و نرخ خطای شرطی (خط بنفش) حتی در صورت درستی فرمول بالا میماند. نمودار راست (تصویر ۴ مقاله): در هر دو حالت آزمون استاندارد (خطچین) و در اختیار گذاشتن مستقیم فرمولها (Gold-P، خط پیوسته)، نرخ بازیابی سازوکار با بالا رفتن پیچیدگی مسائل به سرعت کاهش مییابد؛ نشانهای از اینکه چالش اصلی صرفاً پیدا کردن فرمول نیست.
این نتایج نشان میدهد که قدرتمندترین سامانهها نیز هرچند در بازنمایی روابط دادهها موفق عمل میکنند، هنوز با تبیین «چرایی پدیدهها» فاصله زیادی دارند؛ تطبیق دادن یک معادله تجربی دلیلی بر درک سازوکار پدیدآورنده آن نیست. اهمیت MechBench در این است که این شکاف را با معیارهای تجربی قابل ارزیابی سنجیده و نشان میدهد که تحلیل سازوکار پدیدهها مرحلهای دشوارتر و تعیینکنندهتر در مسیر هوش مصنوعی برای علم به شمار میرود.
۴. جمعبندی:
از درک «چیستی» تا تبیین «چرایی»
پروژههای SRHarness و MechBench دو افق را در کشف علمی هدف گرفتهاند: نخست، ایجاد سامانههایی برای فرمولبندی روابط ریاضی و دوم، محک زدن فهم سامانهها از سازوکارهای علمی حاکم بر این روابط. هر دوی این پروژهها بر یک تغییر مسیر تمرکز دارند: تکامل AI for Science از «شبیهسازی مشاهدات» به سمت «تحلیل سازوکارها» و تغییر از تولید مقطعی فرمول به سمت جستجوهای مستمر علمی. عاملهای هوشمند در آینده صرفاً ترکیبی از «یک مدل محاسباتی و چند دستور ورودی» نخواهند بود، بلکه نیازمند ادغام هماهنگ مدلها، راهبردهای ارزیابی و ساختارهای اجرایی کارآمد هستند. بسترهایی که بتوانند استفاده از ابزارها را تسهیل کرده، سوابق فرضیهها را ثبت نمایند، شواهد را به کار گیرند و سازوکارها را به شکلی نظاممند ارزیابی کنند، مسیر گذار هوش مصنوعی از «شناسایی روابط تجربی» به «تبیین علمی سازوکارها» را هموار خواهند کرد. شاید گام بعدی در تحول AI for Science همین باشد: نه تنها ثبت اینکه جهان «چگونه رفتار میکند»، بلکه پاسخ به اینکه رویدادها «به چه دلیل رخ میدهند». مشخصات مقالهها [1]. Yu Z, Zhou S, Huang H, Ding J, Li Y. SRHarness: A Harness for Agentic Symbolic Regression. https://arxiv.org/abs/2609.35501 [2]. Yu Z, Zhang J, Cheng J, Ding J, Li Y. MechBench: Can AI Scientific Agents Discover Mechanisms beyond Phenomenal Laws? https://arxiv.org/abs/2609.35515 [3]. Ding J, Zheng Y, Xu F, et al. Understanding emergence in complex systems using abductive AI. https://www.nature.com/articles/s42254-025-00895-5 [4]. Yu Z, Ding J, Li Y. Discovering network dynamics with neural symbolic regression. https://www.nature.com/articles/s43588-025-00893-8
حلقه مطالعاتی «ساختارهای سازمانی پیچیده در عصر هوش مصنوعی» عاملهای هوشمند بر پایه مدلهای بزرگ زبانی اکنون در مسیر گذار از عاملهای منفرد به سمت شبکههای چندعاملی (Multi-Agent Systems) قرار دارند. با ورود این عاملهای تصمیمگیر خودکار به ساختارهای تولیدی، چارچوبهای سازمانی متعارف با تغییرات بنیادین روبرو شدهاند. پدیدههای پیچیده صرفاً برآیند خطی قواعد ساده نیستند، بلکه از تعامل میان کنشگران مستقل شکل میگیرند. در این فضا، طراحی الگوهایی بر پایه دانش سامانههای پیچیده ضرورت دارد تا پژوهشها به جای تمرکز محدود بر «بهرهوری ابزارها»، به چگونگی تکامل ساختارهای مشترک میان انسان و عاملهای هوش مصنوعی بپردازند. در همین راستا، Swarm Club با همکاری The Manifold، دوره مطالعاتی «ساختارهای سازمانی پیچیده در عصر هوش مصنوعی: سامانههای چندعاملی و پدیدههای نوظهور» را آغاز کرده است تا به بازخوانی منابع علمی، بررسی الگوهای نظری و مطالعه کاربردهای عملی این حوزه بپردازد. این نشستها از ۲۴ اکتبر ۲۰۲۶ به مدت ۱۲ هفته در روزهای شنبه (ساعت ۱۰:۰۰ تا ۱۲:۰۰) به صورت مجازی برگزار خواهد شد.